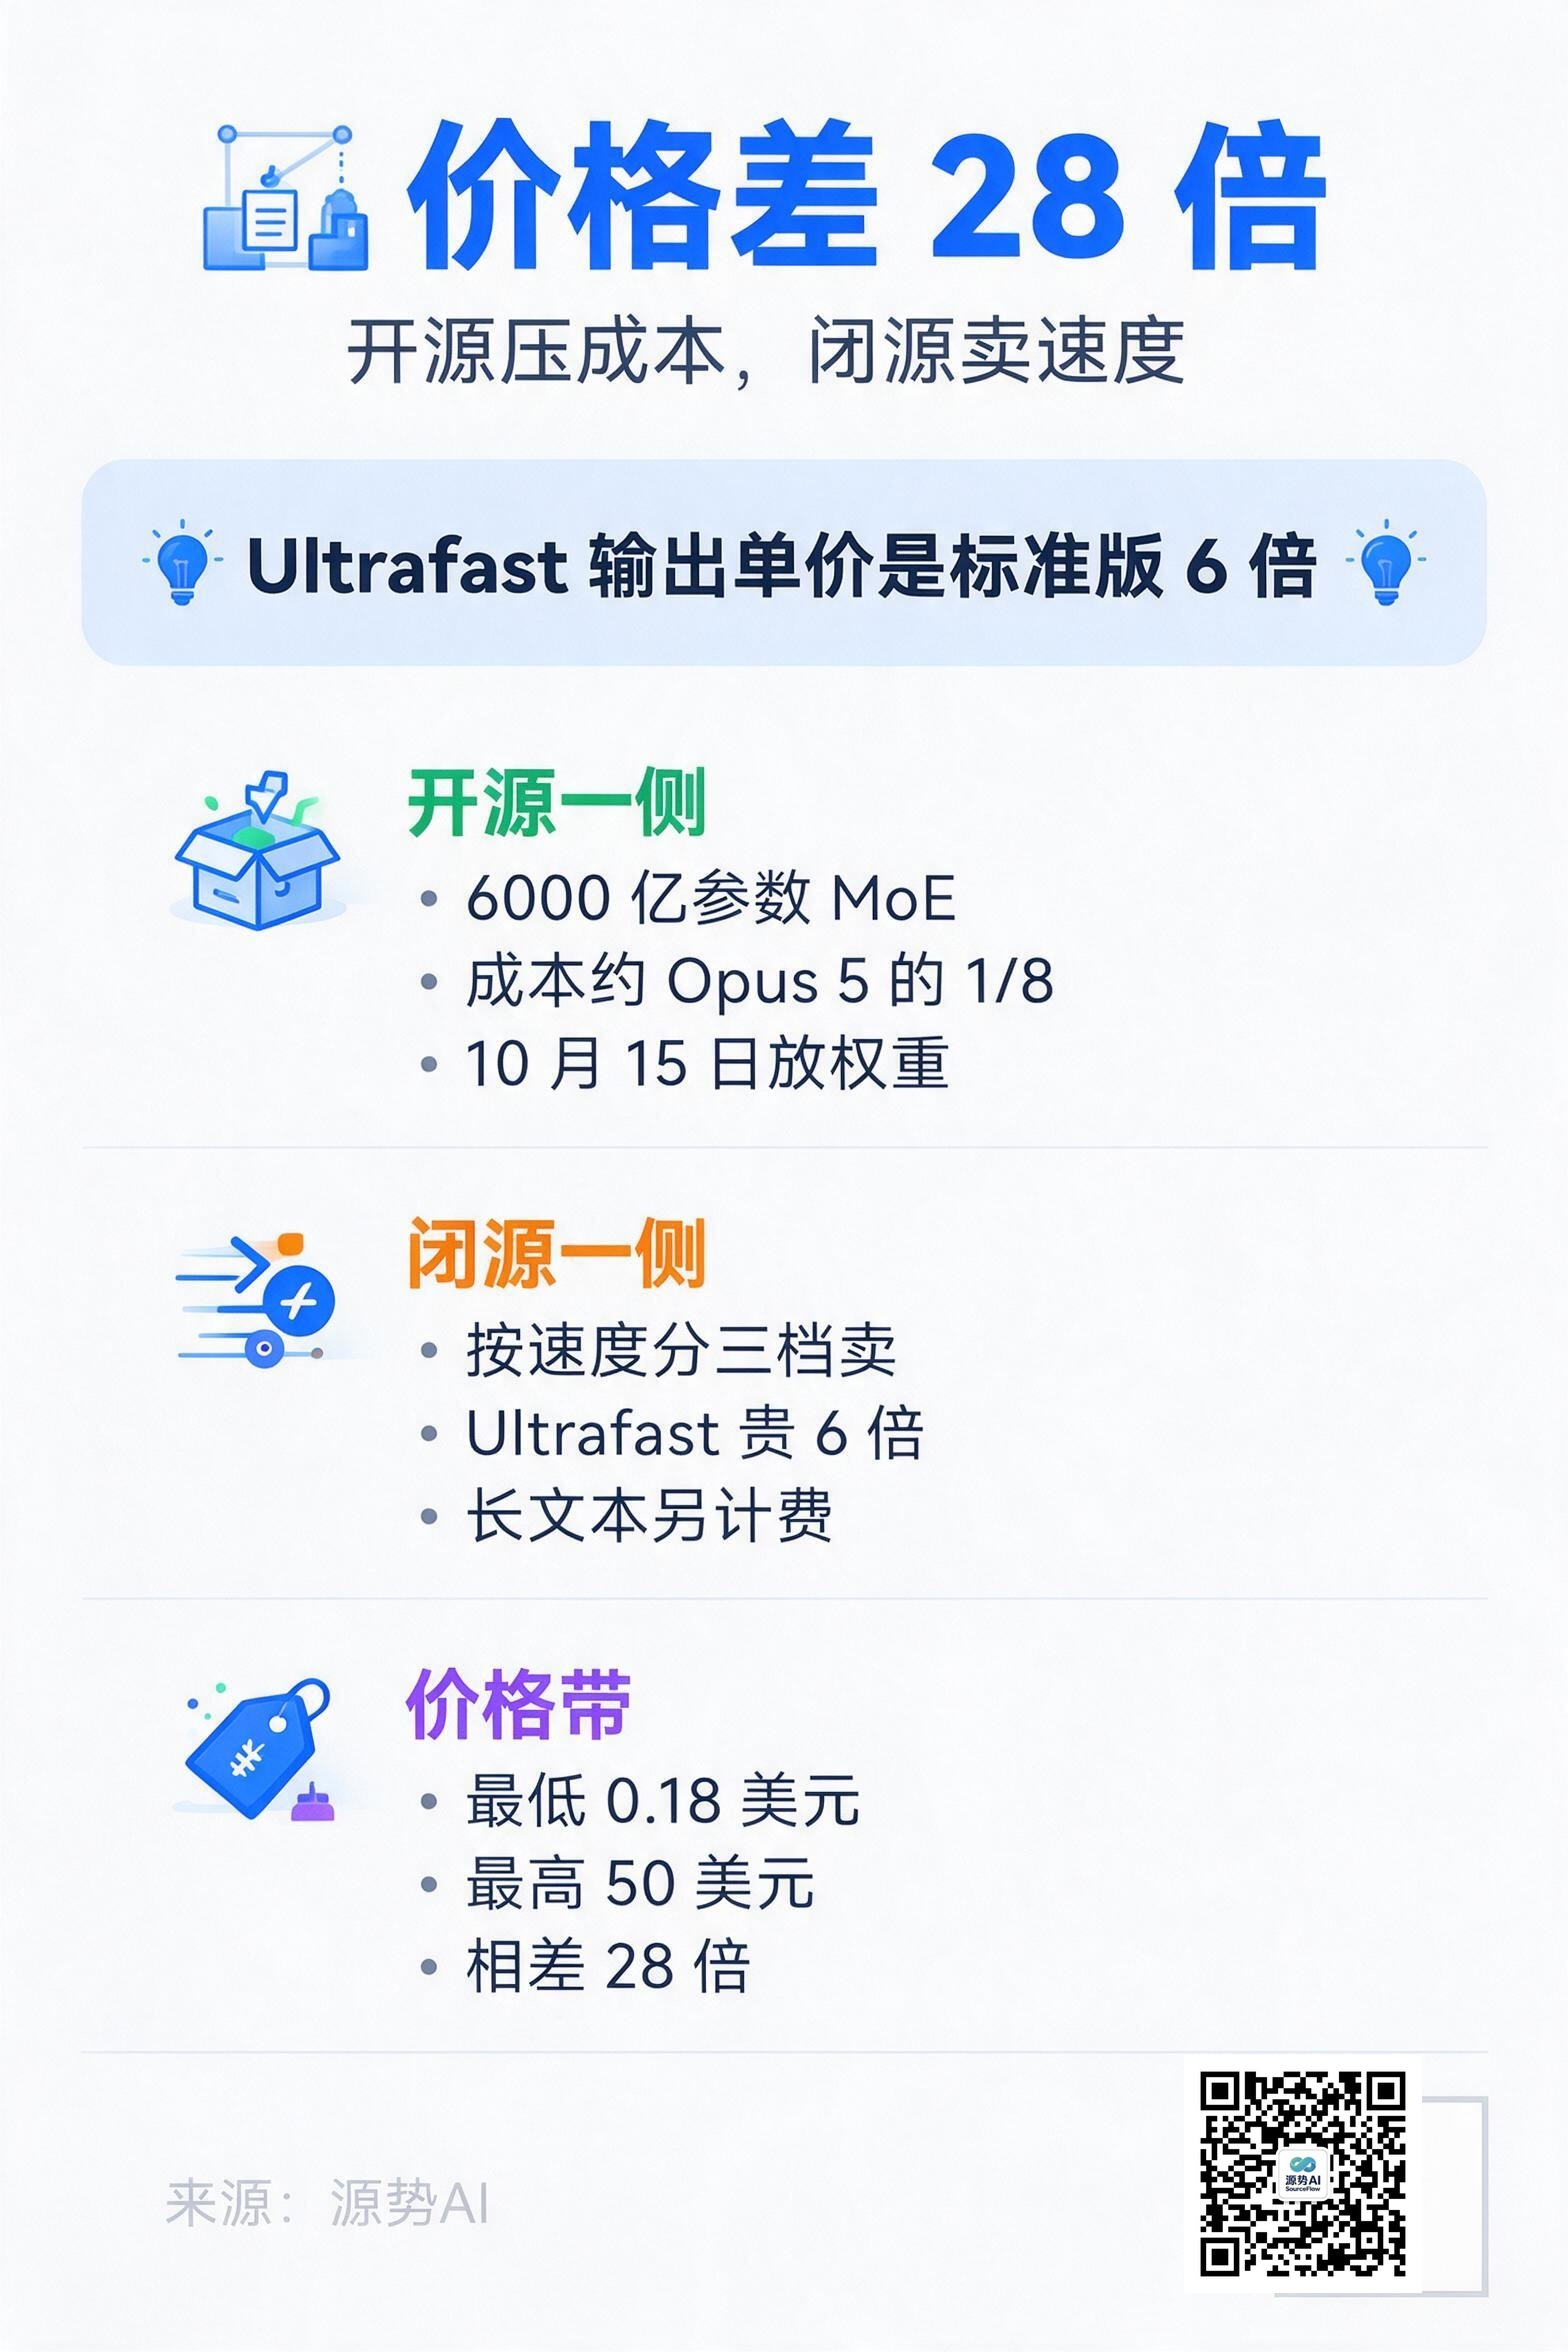
10 月 10 日,阶跃星辰的 Step 5 Preview 登顶 OpenRouter Trending 榜,并位列日榜全球第二;模型采用稀疏 MoE 架构,总参数量 6000 亿、每个 Token 激活约 270 亿,支持 100 万 Token 上下文窗口,原生支持文本与视觉输入(来源:新浪财经(格隆汇),2026-10-10,转引自 Tech Digest《AI行业24小时_20261011_10》)。
更关键的是两个数字:Artificial Analysis 综合智能指数 44 分,位列全球开源前三;官方称将于 10 月 15 日正式释放模型权重,单任务成本约为 Claude Opus 5 的 1/8(来源:新浪财经(格隆汇),2026-10-10)。
口径也要说清:Trending 榜是开发者调用热度榜,不是能力榜,日榜第二为 10 月 10 日的时点快照;"44 分 / 开源前三"为 Artificial Analysis 口径,与闭源旗舰仍有差距;"1/8 成本"是官方对比,未给任务分布与统计窗口(来源:新浪财经(格隆汇),2026-10-10)。
一边冲榜,一边卖提速包
几乎同一时间,闭源那边在推另一种生意。
OpenAI 上线 GPT-6.1 Sol 的 Ultrafast 极速模式,在 API、Codex、ChatGPT Work 三处同步推送,官方称生成速度最高为标准模式的 8 倍,约每秒 300 token(来源:36氪授权转载新智元,2026-10-09,转引自 Tech Digest《AI行业24小时_20261011_10》)。Sol 现按速度分三档售卖:标准版每百万 token 输入 2 美元、输出 10 美元,Fast 档价格翻倍,Ultrafast 输入 12 美元、输出 60 美元——是标准版的 6 倍(来源:36氪授权转载新智元,2026-10-09,转引自 Tech Digest《AI行业24小时_20261011_10》)。
有意思的是成本结构:GPT-6.1 Sol 在长程软件工程基准 DeepSWE v1.1 上与旗舰 Astra 打平、成本约其 1/5,短板是速度,标准版实测约 20 到 31 token/s(来源:36氪授权转载新智元,2026-10-09)。社区对 Ultrafast 的质疑集中在一点:先降低基础速度,再卖提速补丁包,等于变相涨价(来源:36氪授权转载新智元,2026-10-09;属用户社区评价,不是评测结论)。
把两件事放进同一张时间表:一边是开源模型把权重放出来,让企业能自己部署、自己压单位成本;一边是闭源厂商把同一个模型切三档,用速度差做溢价。两条路都可能赚钱,但对采购方来说判断标准只有一个——同样的任务,谁的年化总支出更低。这也是我们建议按季度重算选型的原因:价格带每个月都在动,去年的最优解,今年可能贵了一倍。
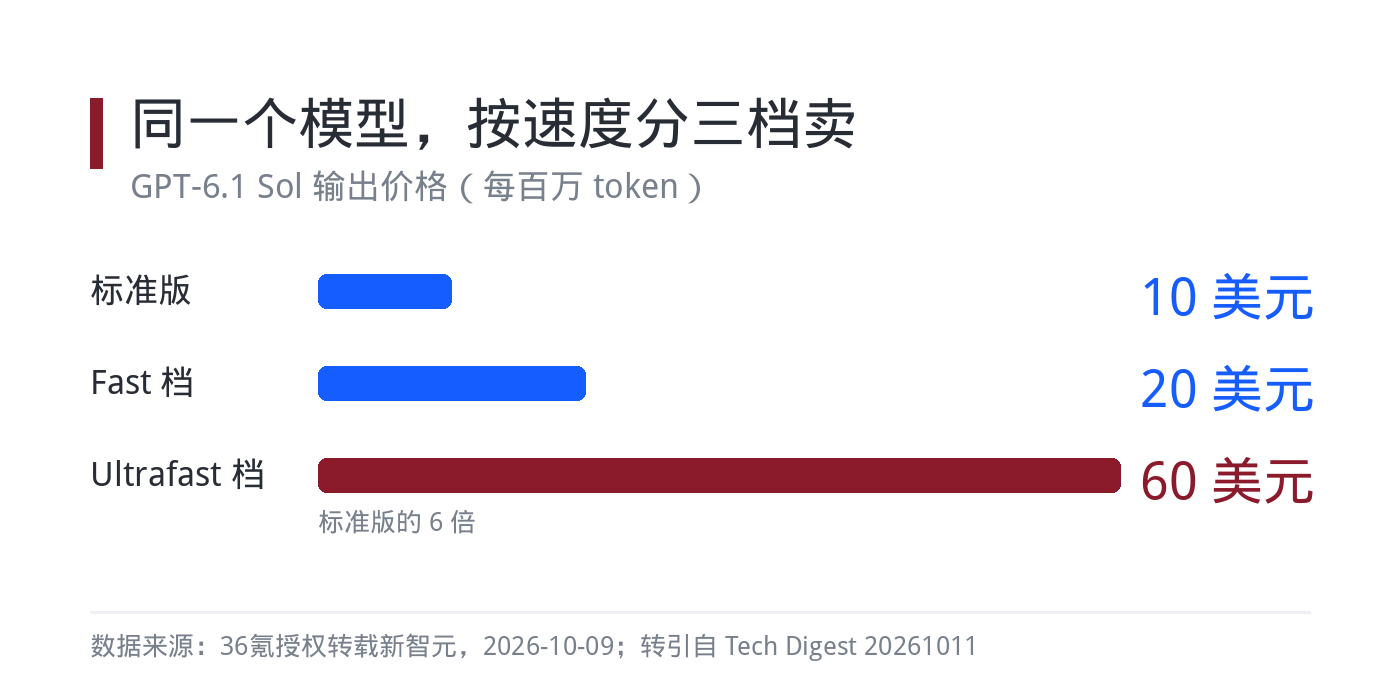
图注:同一个模型按速度分三档卖,Ultrafast 的输出单价是标准版的 6 倍(数据来源:36氪/新智元,2026-10-09)
28 倍价差,是这轮价格战的底色
把镜头拉远,价差比单个模型更值得记。
研究报告《Token Factory:AI 推理的成本革命》梳理了 2026 年 7 月那场开源"无限战争":一个月内四家中国厂商密集发布——Kimi K3(2.8T 参数)、DeepSeek-V4(1.6T 参数,成本仅前代的 27%)、GLM-5.2、Qwen3.8(2.4T 参数)。按每百万 token 报价排列:DeepSeek V4 Pro 0.18 美元、GLM-5.2 0.9 美元、Qwen3.7 Max 1.4 美元、Kimi K3 2.3 美元,而 GPT-5.6 Sol 是 5 美元、Claude Fable 5 是 50 美元——28 倍价差(来源:研究报告《Token Factory:AI 推理的成本革命》,AI-Fundamentals)。
报告引述的判断是,开源与闭源的能力差距已经缩到 3 到 5 个月(该判断出自报告所引 Kimi 美国研究员,属访谈观点,非实测结论)。这个窗口意味着,企业自建"Token 工厂"从选项变成了可算账的方案(来源:研究报告《Token Factory:AI 推理的成本革命》,AI-Fundamentals)。
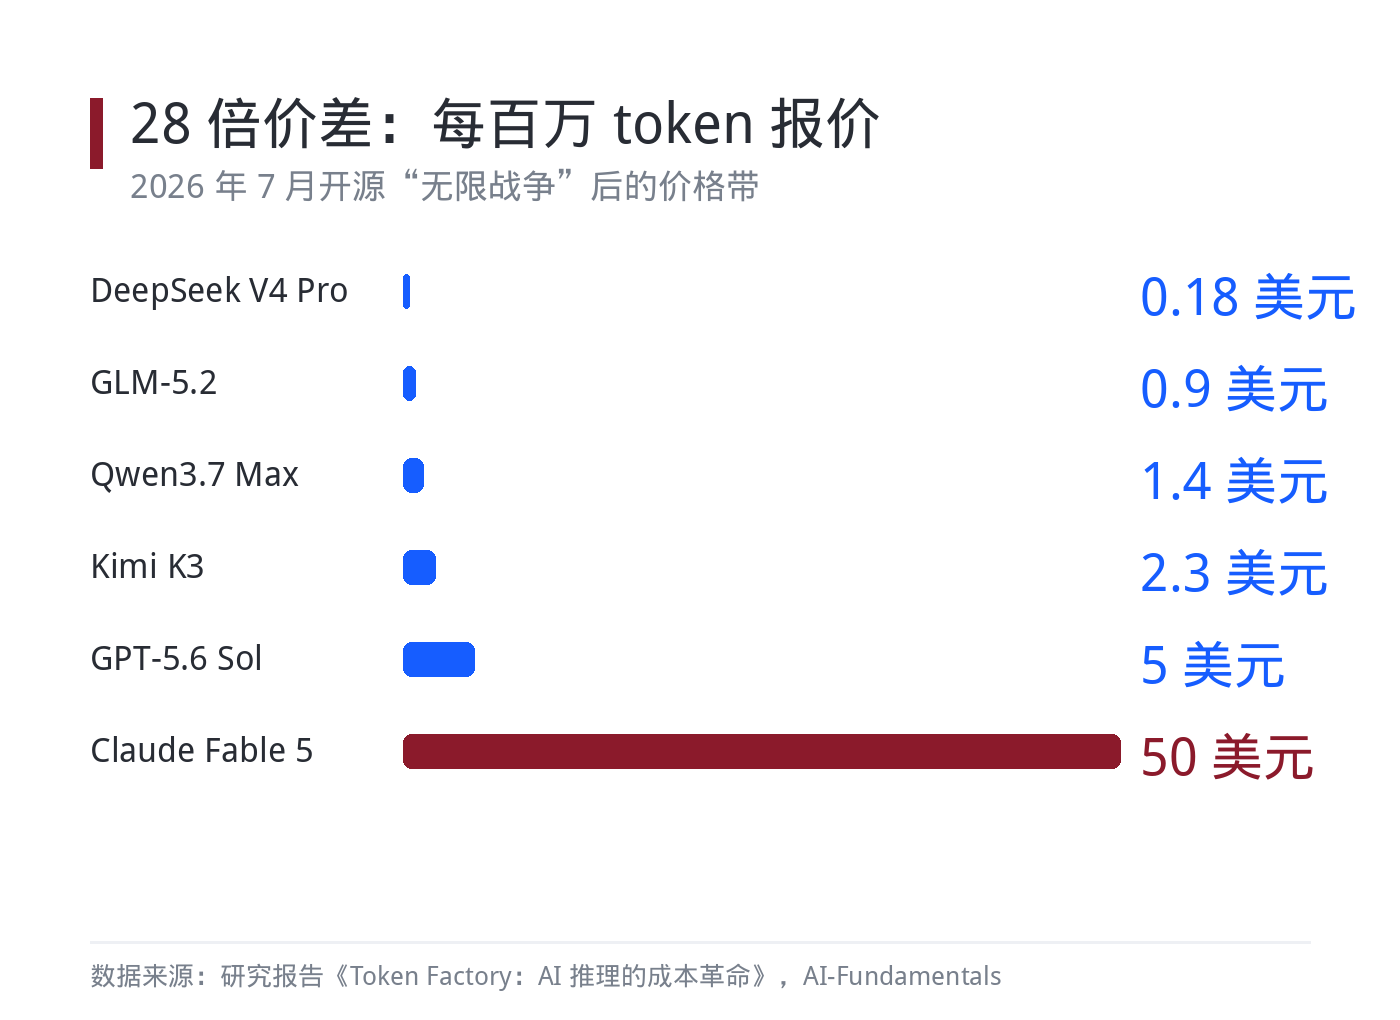
图注:同一批旗舰模型里,最便宜与最贵的单价差 28 倍(数据来源:研究报告《Token Factory:AI 推理的成本革命》)
便宜的底层,是成本曲线在降
价差不是营销,是工程。
另一份基于 OpenRouter 聚合定价数据的分析指出:输出的单价远贵于输入,原因在 Decoding 阶段的显存带宽受限;缓存读通常比标准输入低 30% 到 90%(来源:研究报告《大模型 API 定价策略定量分析框架与成本测算》,AI-Fundamentals)。而推理成本通常占大型 AI 服务商总运营成本的 80% 到 90%(来源:研究报告《AI 推理成本分析》,AI-Fundamentals)。
谁把缓存、路由、量化这些环节做好,谁就能在同样的能力下把单价压下去。价格战打到最后,比的不是谁敢亏,是谁的成本结构更干净。
对我们做聚合的人来说,这个成本结构直接决定能报出什么价。谁能把缓存命中率做上去、把简单任务路由到便宜模型,谁就能在不牺牲体验的前提下把单价压下来。反过来,只卖"更快的同一档"这种模式,迟早会被自家标准档的速度改善吃掉——提速这件事,本身也会降价。
源势AI观点
我们做 Token 聚合,站的位置恰好在这两股力量的中间。
第一,不该让企业为"最快"这一档多付几倍的钱。真实业务里,能容忍 300 token/s 的场景是少数,大多数任务要的是稳定和便宜。把模型按任务分流——简单任务走开源、复杂任务走闭源——是我们给客户的默认动作;能省多少,取决于业务里简单任务占多大比例,所以我们在选型阶段会先算一张分流表,而不是先报一个降本数字。
第二,价格波动比能力波动更难管理。同一批模型之间的价差,一个月里就能拉开一个数量级,意味着选型不能一年做一次,得按季度重算。我们给客户的建议是保留可切换的接口层,别把业务硬绑在某一个模型的报价单上。
第三,看到"1/8 成本"这类数字,先问口径。官方对比、第三方评测、社区口碑是三件事,混在一起既会亏钱,也会让报价失去可比性。
话题标签:#开源模型 #推理成本 #价格战
