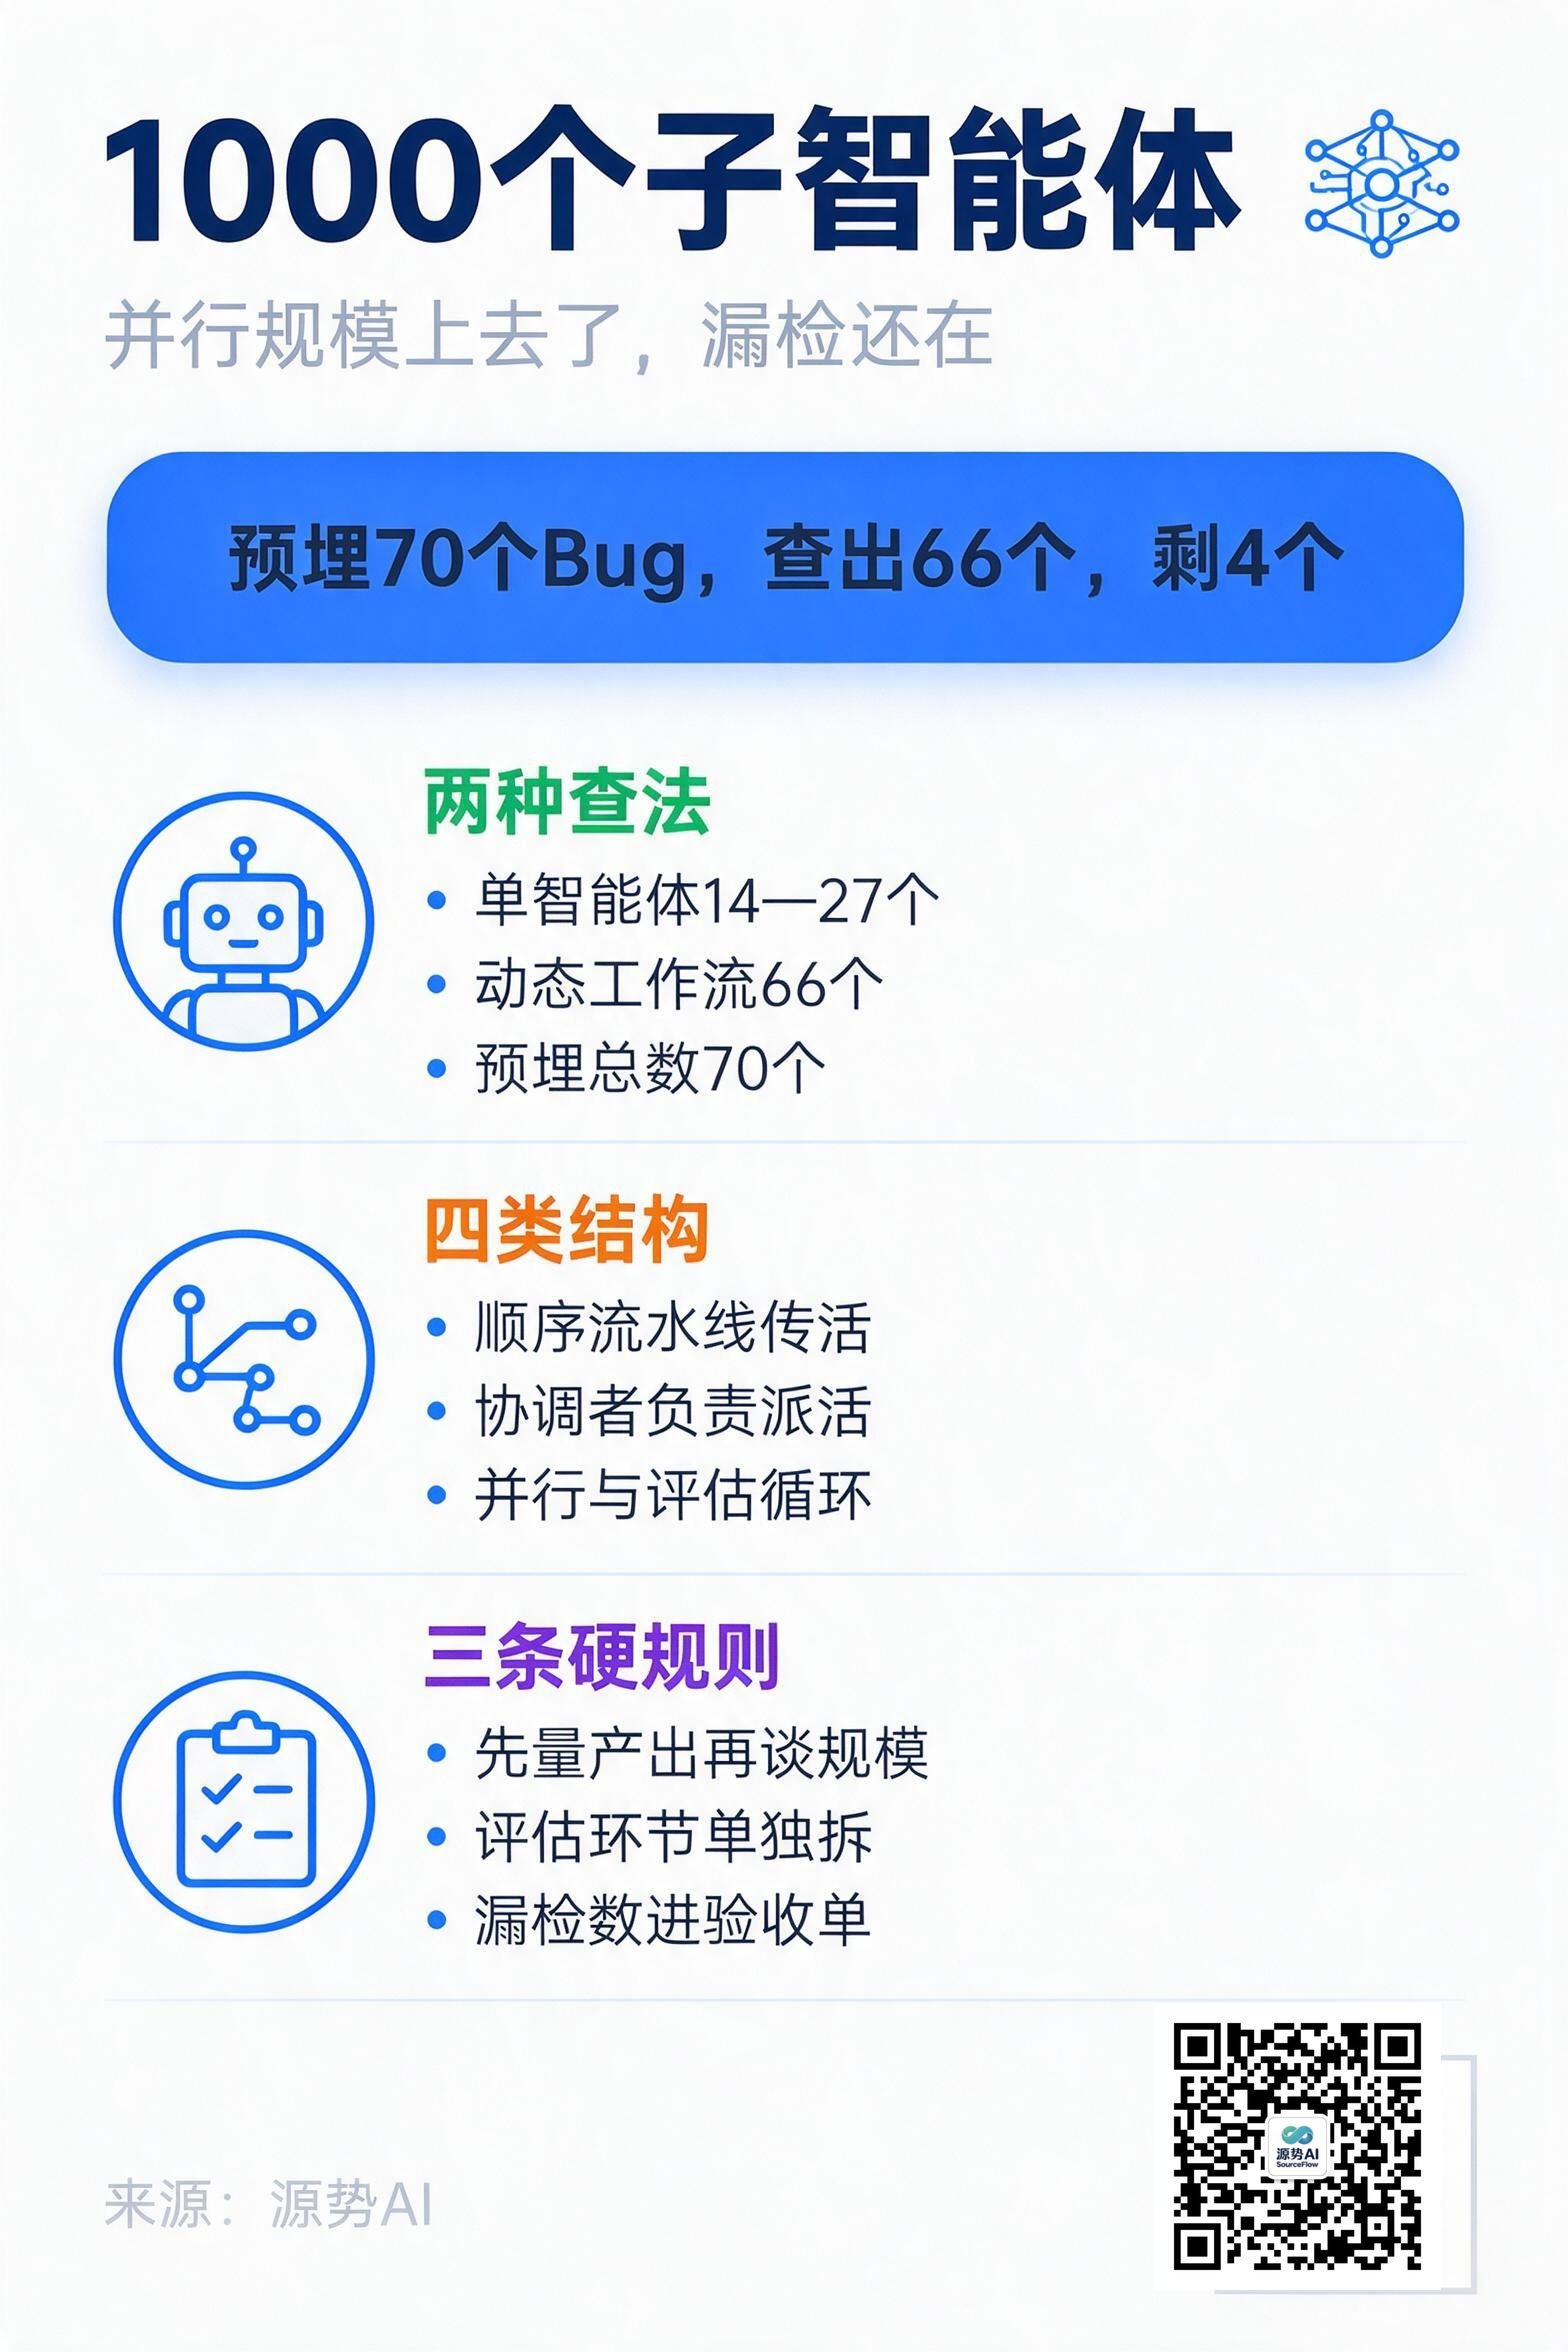
Anthropic 给 Claude 装了一个新调度器:一个主智能体自己拆任务、派活、收结果,单次执行最多并行协调 1000 个子智能体。它用漏洞检测做了对照,产出确实涨了,但没抓全。
10 月 9 日,Anthropic 发布公告,为 Claude 管理智能体引入"动态工作流":由主智能体规划任务、分派子任务,子智能体完成后汇总结果,单次执行最多并行协调 1000 个 AI 智能体(来源:IT之家,2026-10-10,转引自 Tech Digest《AI行业24小时_20261012_10》)。演示用的代码库有 11.6 万行,预埋 70 个 Bug。单智能体每次运行检出 14 到 27 个;公告称动态工作流能稳定检出 66 个(来源:《AI行业24小时_20261012_10》,2026-10-10)。
66 比 27 高出一倍多。换个方向读同一组数字:70 减 66,还剩 4 个。
拆得开,才收得回
这件事的工程味道,比数字本身更值得看。
多智能体系统的结构其实就那么几种。《智能体设计模式》把常见形态拆成顺序流水线、协调者-工作者、智能体并行化、评估优化循环四类,落到实际操作就是四个问题:活儿按什么顺序传、谁派活、哪几件能同时干、谁判断干得行不行(来源:《智能体设计模式》,Marco Fago 等,2026)。动态工作流把前三个问题交给模型自己回答,这正是它和传统工作流的分界——分支由程序规定的叫工作流,由 Agent 按当前结果自己定下一步的才叫 Agent。
最容易漏掉的是第四个问题。写手和改手如果共用一套判断标准,错会一起错;单独放一个评估环节的意义不是多一个角色,是多一套标准。1000 个子智能体并行改代码,如果没有独立验收,规模只会把同一个错误复制一千份。
拆分之后还有一层麻烦,是任务的状态管理。工作交出去了怎么知道对方做完没有,遇到问题谁来处置,用户中途换了需求又怎么找到对应的任务并调整后续安排(来源:《一文讲透多Agent协作:4种模式、3个判断标准、4大工程落地陷阱》,2026-09-12)。这类能力通常不是某个独立的项目管理软件,而是协调 Agent 通过程序提供的一组查询接口拿到的——哪个子任务交给了谁、做到第几步、结果存在哪里,都要能查。10 个智能体时这套东西可以靠人盯着,1000 个只能靠系统。
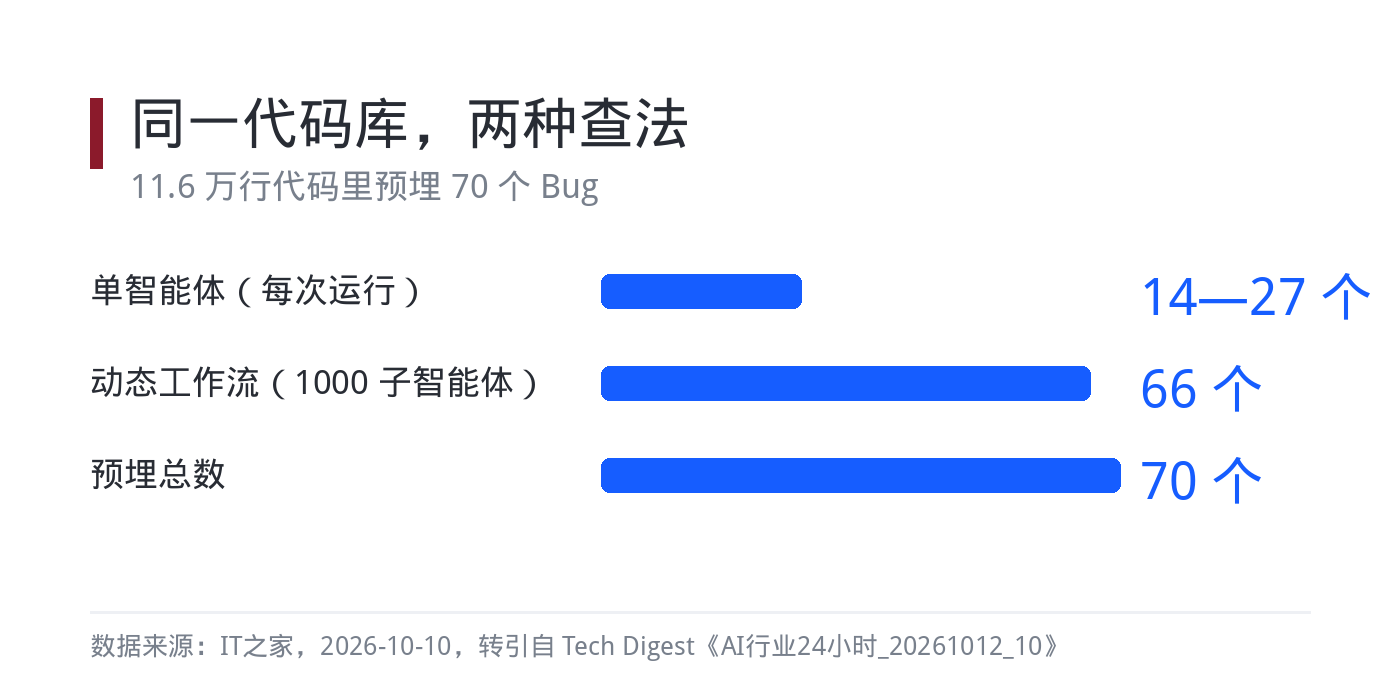
图注:预埋 70 个 Bug,单智能体每次检出 14—27 个,动态工作流检出 66 个(数据来源:IT之家,2026-10-10)
1000 是上限,不是日常
厂商公布的数字,要按厂商的测试条件读。
公告里的 1000 是单次执行的并行上限,不是日常负载,实际可用数量取决于资源与任务拆分粒度。这次对照也由 Anthropic 自行设计并公布,没有第三方复现;公告没有给出运行次数与方差,"稳定检出 66 个"里的"稳定"是公告自己的表述(来源:IT之家,2026-10-10,转引自 Tech Digest《AI行业24小时_20261012_10》)。
"66"这个数字同样要按下限读:在同一套埋点方式下仍有 4 个漏检,它不能外推成通用缺陷检出率。真正有意义的对照口径是:同一批子智能体在单次运行里到底能协调多少、漏检率怎么随并行规模变化。这两项公告都没有给。
把范围放大看,企业对多智能体的期待早就在了。中国信通院人工智能研究所与 360 联合发布的《企业级智能体技术与应用研究报告(2026 年)》判断,跨系统、长流程任务里单个智能体常因能力边界受限难以独立完成,要靠任务拆分与多方协作把闭环效率提上来;报告转引的 IDC 预测称,到 2027 年 45% 的企业将管理跨渠道、跨应用、跨供应商的多智能体(来源:中国信通院人工智能研究所、360《企业级智能体技术与应用研究报告(2026年)》,2026-06)。
预测是一回事,能跑起来是另一回事。企业侧最先撞上的往往不是模型智商,是分工之后的状态管理与验收标准。这些问题在 10 个智能体时会暴露,在 1000 个时会放大;而规模越大,能容忍的漏检就越少。
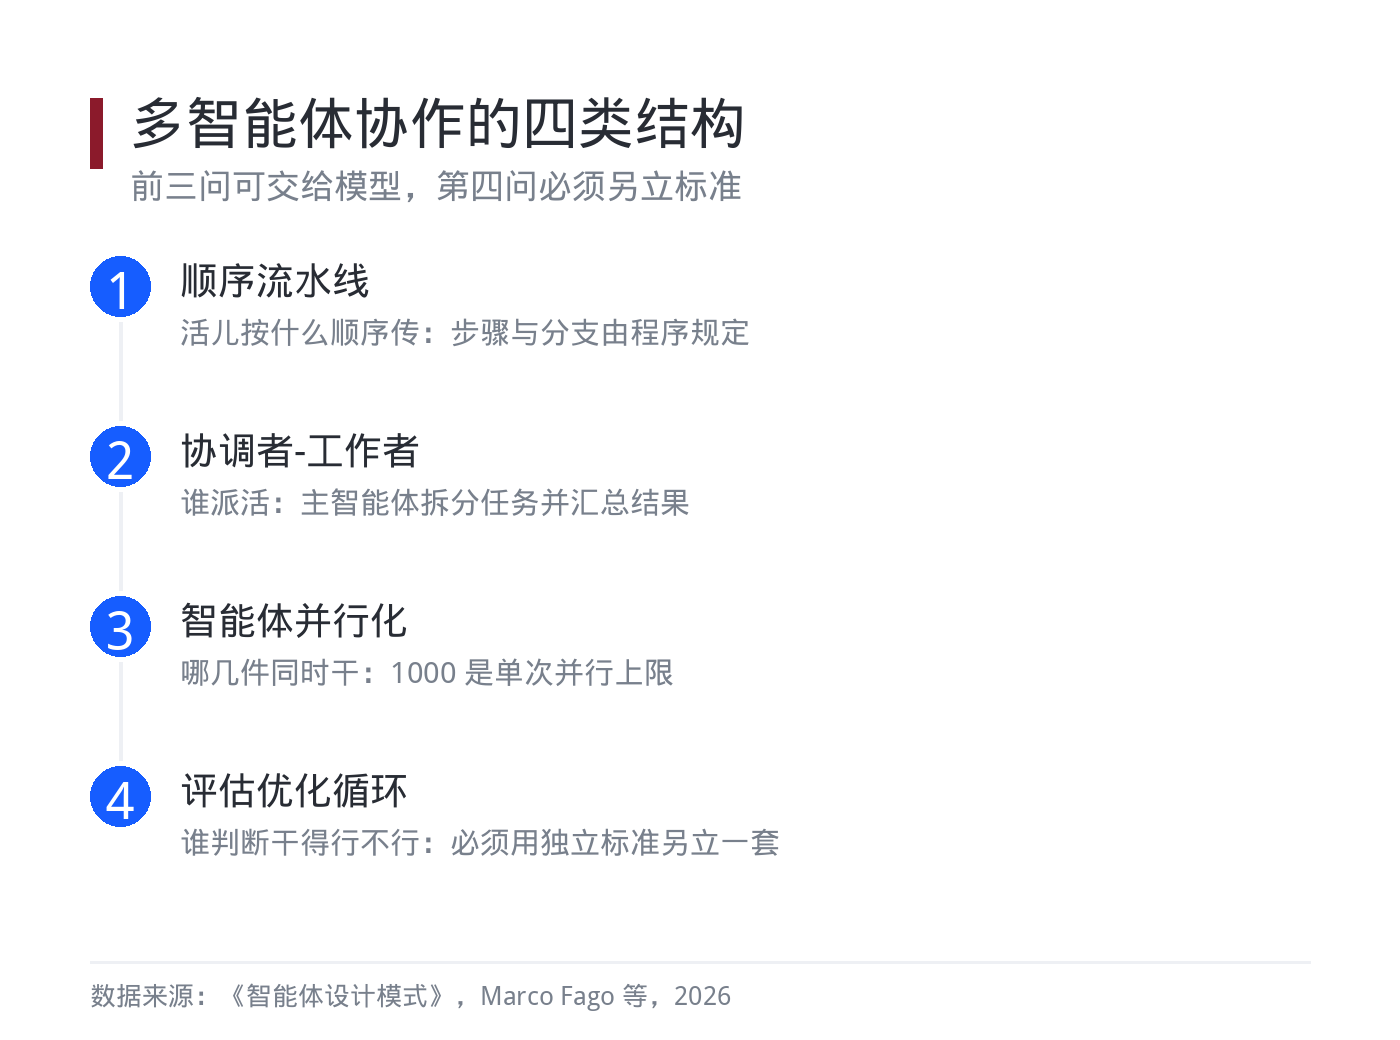
图注:顺序、协调、并行、评估四类结构对应四个问题,前三问可以交给模型,第四问必须另立标准(数据来源:《智能体设计模式》,Marco Fago 等,2026)
源势AI观点
第一,先量产出,再谈规模。这次对照最有价值的地方不是 66,是它给了一个可复现的对比口径:同一个代码库、同一批埋点、单智能体与集群各跑一遍。企业评估多智能体方案时,也该先要这样一组对照数据,而不是先看能挂多少个子智能体。
第二,把评估环节单独拆出来。1000 个执行者共用一套验收标准,等于没有验收。我们给企业做 Agent 落地时,评估 Agent 与执行 Agent 分属不同上下文、不同标准,这是拆分的第一条硬规则。
第三,给并行设一个成本闸门。并行的代价是 token 与调度开销,1000 个子智能体不是每次任务都划算。我们的做法是按任务拆分粒度设上限,先跑 10 个验证闭环,再决定要不要放大。
第四,把漏检数写进验收单。检出 66 个不等于全部找出,那只说明这一批埋点里还剩 4 个。对交付方来说,可核的指标是"漏了几个、漏在哪一类",不是"查出了几个"。
话题标签:#多智能体 #Agent调度 #检出率
