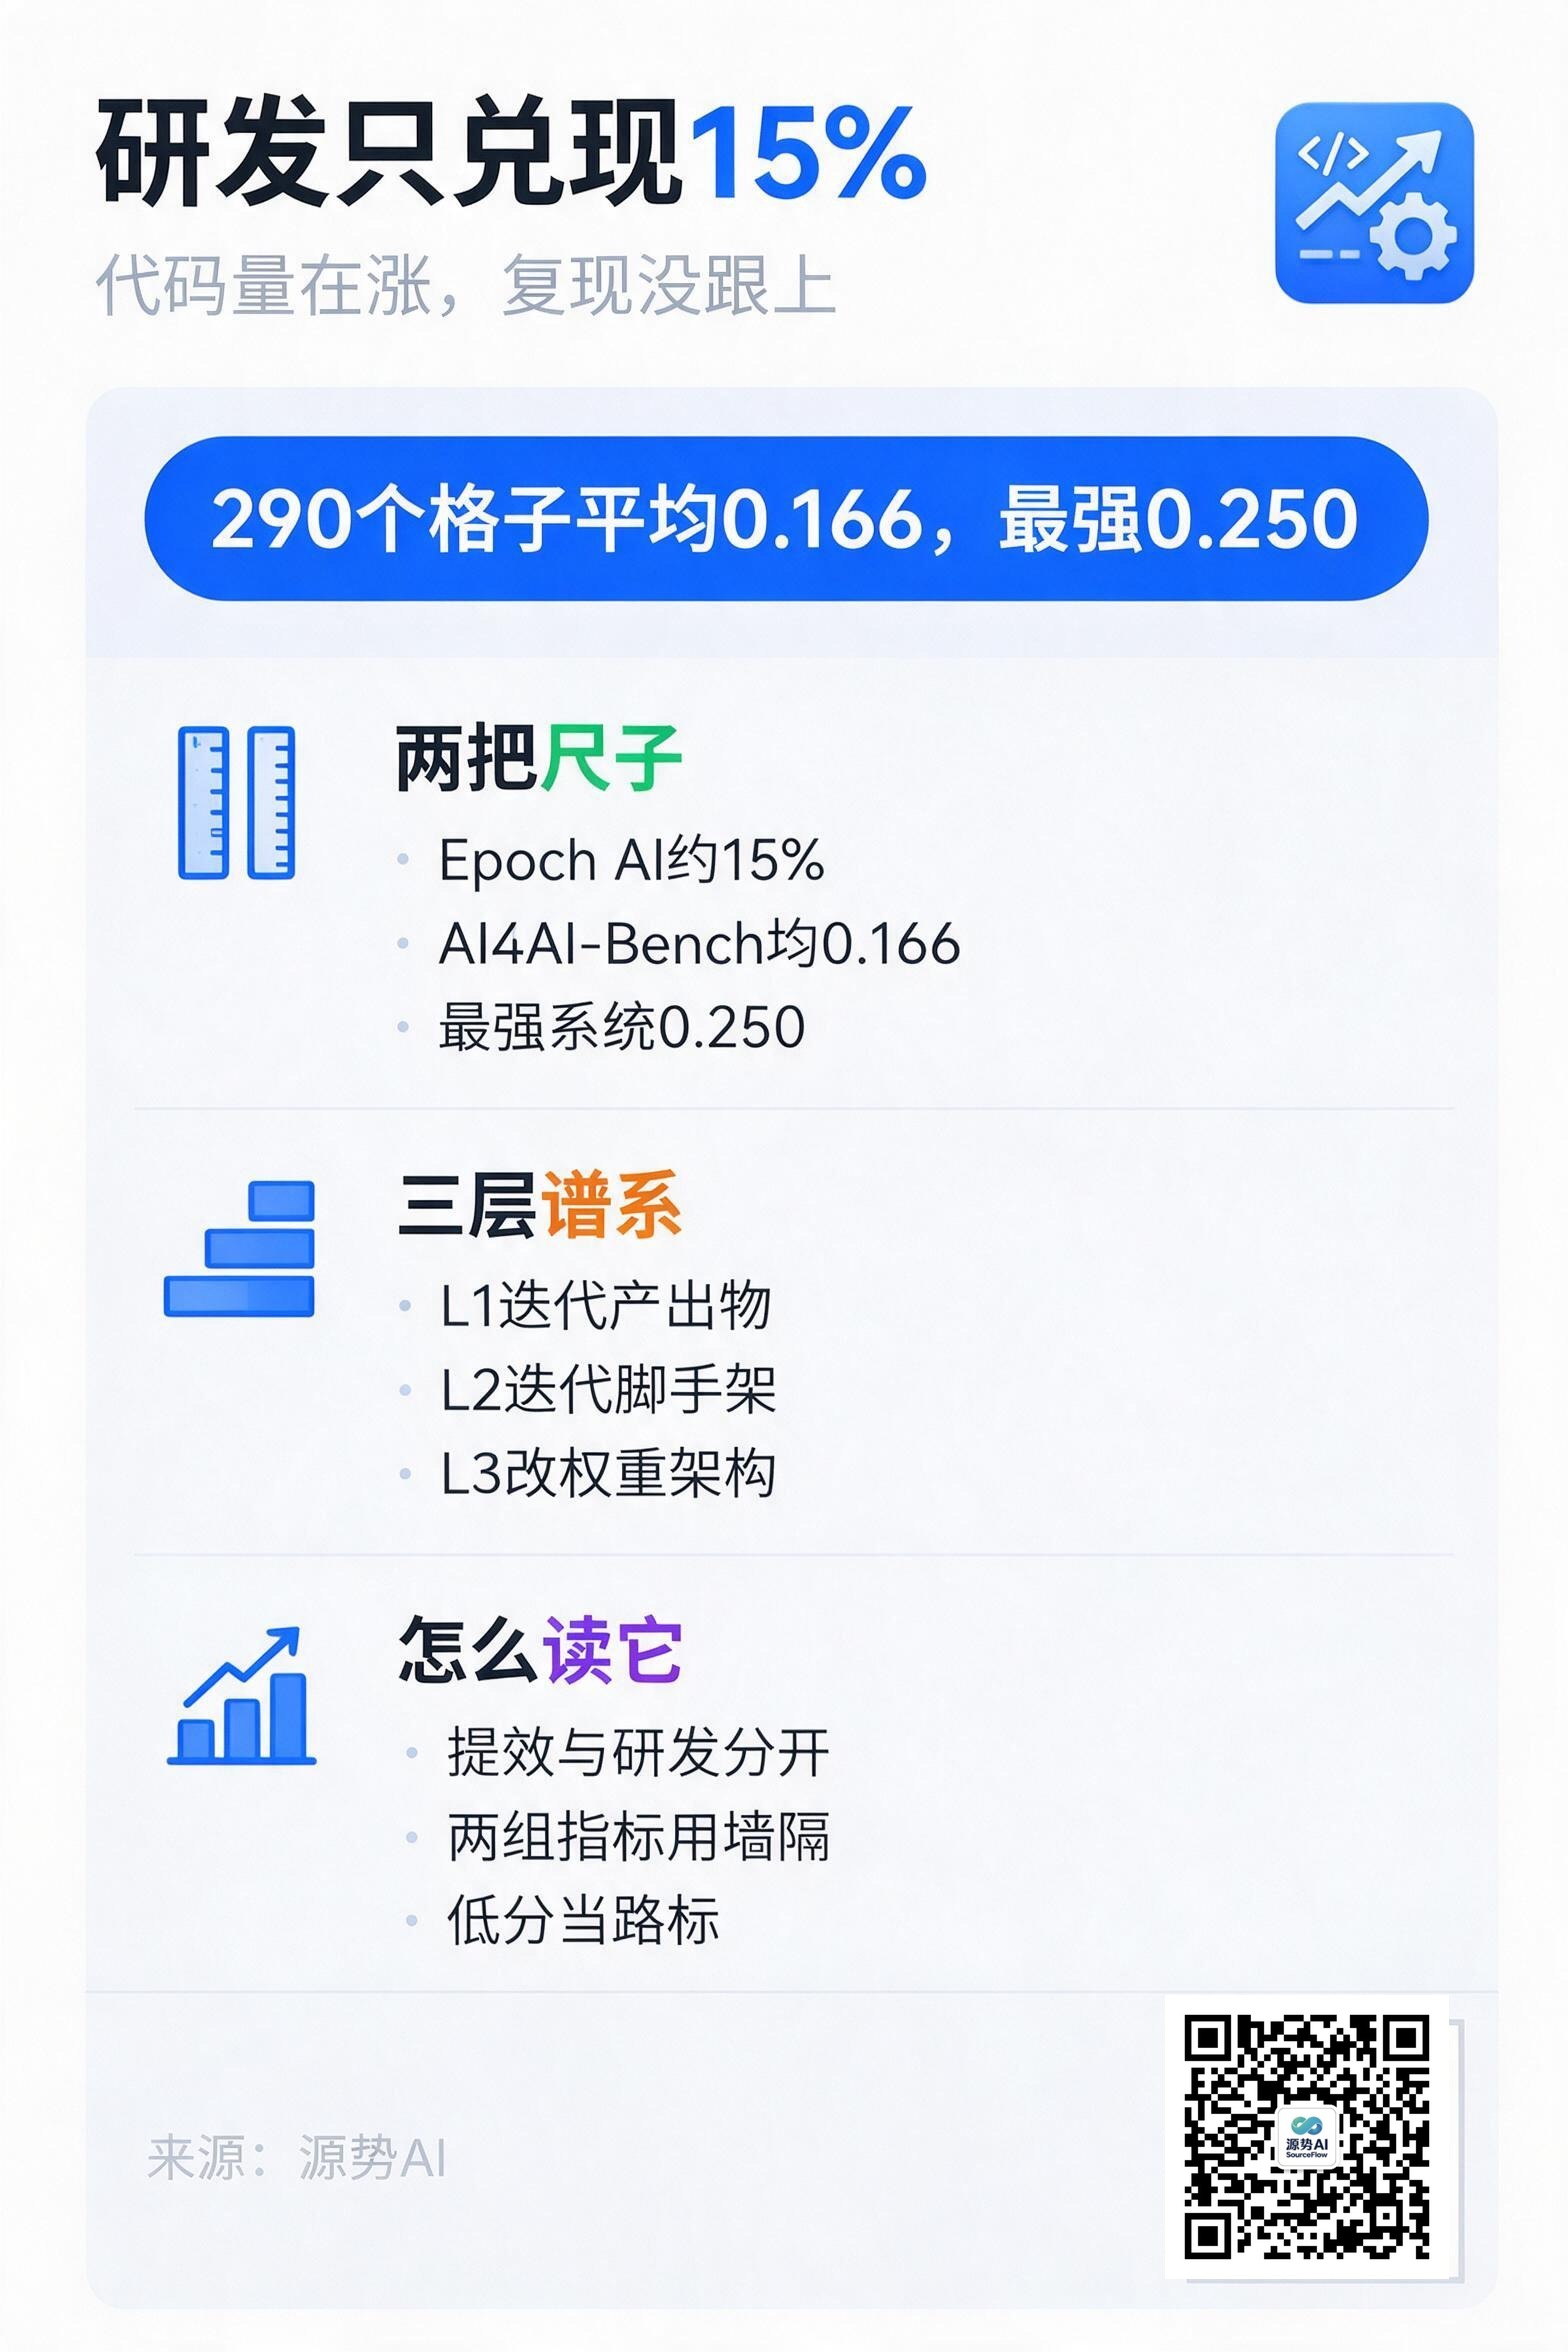
AI 接管研发这件事,一边在加速,一边在被量。加速的是代码量,被量出来的是它离"独立搞出研究创新"还有多远。
10 月 10 日,研究机构 Epoch AI 发布评测 InnovationEval(《Can AI automate AI R&D yet?》),用"前沿模型能否独立复现人类论文里的机器学习创新"来检验"AI 自动化 AI 研发"这个叙事,对照对象是 AI 论文中提出的一种方法 SDPO。结论是:前沿模型目前只达到人类论文所取得增益的约 15%(来源:Epoch AI,2026-10-10,转引自 Tech Digest《AI行业24小时_20261012_10》)。
乐观的证据也在同一周。Epoch AI 的报告把两组对照摆在一起:一侧是前沿模型在复现实验上的得分,另一侧是厂商公布的效率数字——Anthropic 报告其员工代码贡献量相比早期基线提升 8 倍,OpenAI 也称 AI 在研究工作里的参与度持续上升(来源:Epoch AI,2026-10-10,转引自 Tech Digest《AI行业24小时_20261012_10》)。这两组数字口径不同:前者量的是代码产出,后者量的是复现研究创新的完成度,不能直接相减。落差恰恰藏在这个口径差里。
一个窄口径的对照
先把口径说清楚,否则这个数字会被读成"AI 什么都不会"。
Epoch AI 测的是"独立复现一篇论文里的方法创新"这一个窄口径,不代表模型在文献检索、实验脚本编写、数据分析这些环节上没用。SDPO 是单一对照方法,样本有限;评测由 Epoch AI 自行设计,未经同行评审;15% 是评测口径下的差值,不能直接换算成整体研发效率(来源:Epoch AI,2026-10-10,转引自 Tech Digest《AI行业24小时_20261012_10》)。
但这个方向上的独立测量,已经不止一次给出相近的答案。
另一把尺子,同一个量级
今年 8 月,Navers Lab、Einsia.AI 与清华大学团队联合发布基准 AI4AI-Bench,把"AI 能不能改进造 AI 的过程"隔离成一个可量化的实验:准备 10 个冻结的研究仓库,每个代表一种训练算法家族;给编码智能体一块 B300 GPU 和 4 小时,让它读懂仓库、改写训练算法;写完的手改代码从零重训最多 12 小时,由智能体根本看不到的隐藏评估器按原算法程序打分。整个设计最关键的一刀是:智能体开发时用的代理指标,和最终决定分数的指标,被一道墙隔开(来源:Navers Lab、Einsia.AI 与清华大学《AI4AI-Bench》,arXiv:2608.20318,2026-08)。
把 290 个格子的结果映射到统一标尺上(0.1 是仓库自带算法,1.0 是任务最优),均值 0.166,最强系统 0.250,单配置最高 0.288;论文的原话是,最强的那个也只走完约五分之一的路,平均则不到一成。290 个格子里有 124 个低于 0.1,也就是超过五分之二的尝试,交回去的仓库比原样更差(来源:Navers Lab、Einsia.AI 与清华大学《AI4AI-Bench》,arXiv:2608.20318,2026-08)。
两个独立团队、两套不同设计,落点都在"不到两成"。这不是巧合,是同一个瓶颈在多把尺子上的投影。
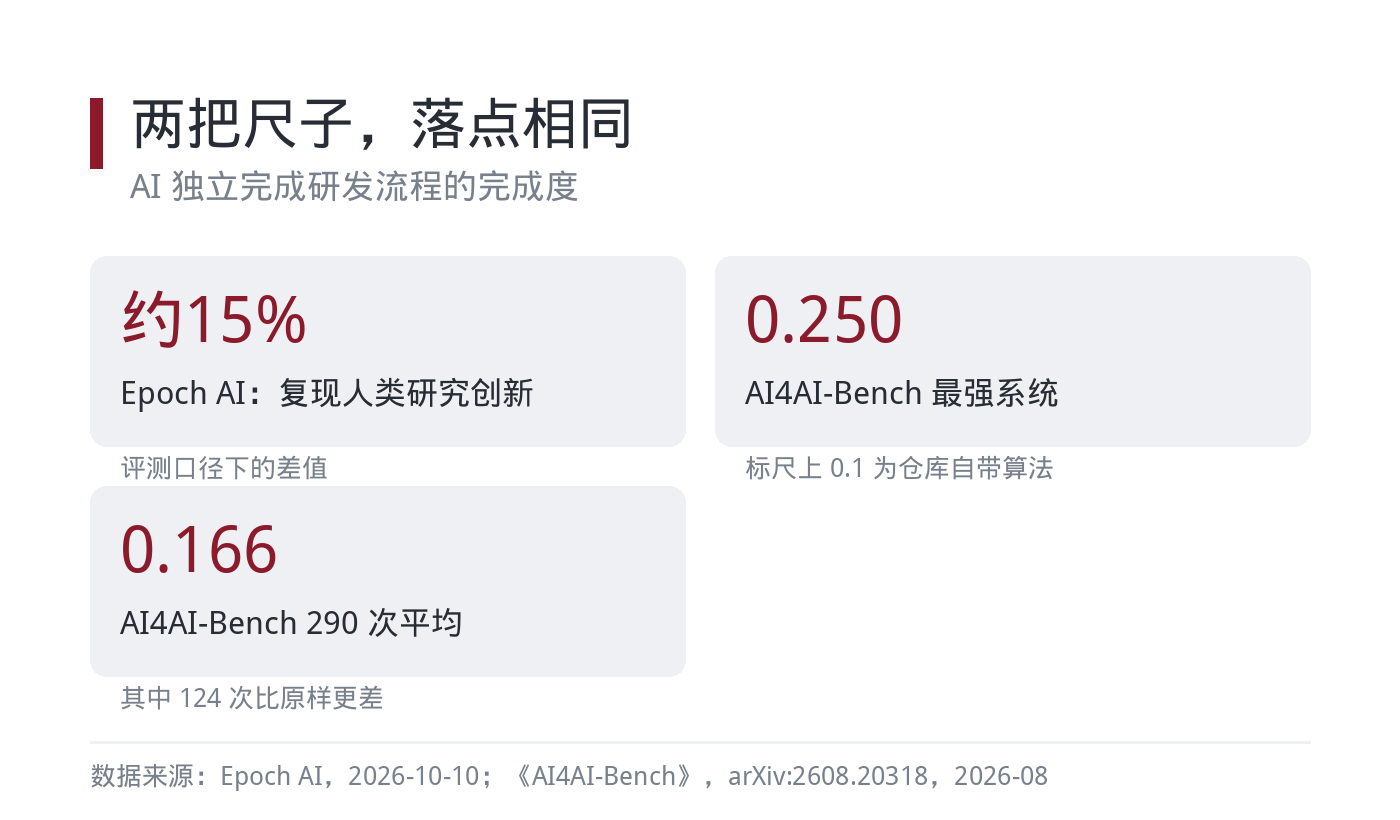
图注:Epoch AI 的 InnovationEval 给出约 15%;AI4AI-Bench 在统一标尺上均值 0.166、最强系统 0.250(数据来源:Epoch AI,2026-10-10;《AI4AI-Bench》,arXiv:2608.20318,2026-08)
涨的是哪一段
要理解为什么"代码产出猛涨"和"研发兑现有限"能同时成立,得看自我改进分了哪几层。
一份技术分析按迭代对象把递归自我改进拆成三层:L1 是产出物迭代,模型权重和脚手架全冻结,只迭代代码、解题步骤这类产物;L2 是脚手架迭代,权重不动,改的是提示词、工具定义、工作流、记忆策略和评测门禁;L3 才动权重与架构,由 AI 生成训练数据、设计超参、产出新权重(来源:《RSI(Recursive Self-Improvement,递归自我改进)核心技术与挑战深度分析》,2026-09-05)。这套 L1/L2/L3 是产业分析的划分口径,不是学界统一的标准定义,但用来区分"哪一段在涨"足够清楚。
代码贡献的涨幅,涨的是 L1 的量。而"设计训练算法"落在 L3,正是 AI4AI-Bench 测的那一层。
前 OpenAI 科学家翁荔在公开讨论中指出,递归自我改进的主战场不在权重而在 Harness——迭代提示词、工具和评测门禁这类运行时脚手架(来源:《前OpenAI科学家翁荔:递归自我改进RSI的主战场不在权重而在Harness》,2026-08-26)。今年 7 月公开的 Frontis-MA1 走的是同一条路:没有造出通用 RSI,但让模型在机器学习任务中提出方案、由外部环境运行评价,成功与失败被整理成经验,继续指导搜索(来源:《AI 的递归自我改进(RSI),可能先从许多局部飞轮开始》,2026-08-28)。
按这个分层,L2 是 2026 年产业真正在动的地方,L3 的账还没结。Epoch AI 与 AI4AI-Bench 测的都是 L3,所以低分不奇怪;它们量的是"最后那一段",不是全部产出。把 L1 的产出当作 L3 的能力来汇报,是目前最常见的一种口径错位。
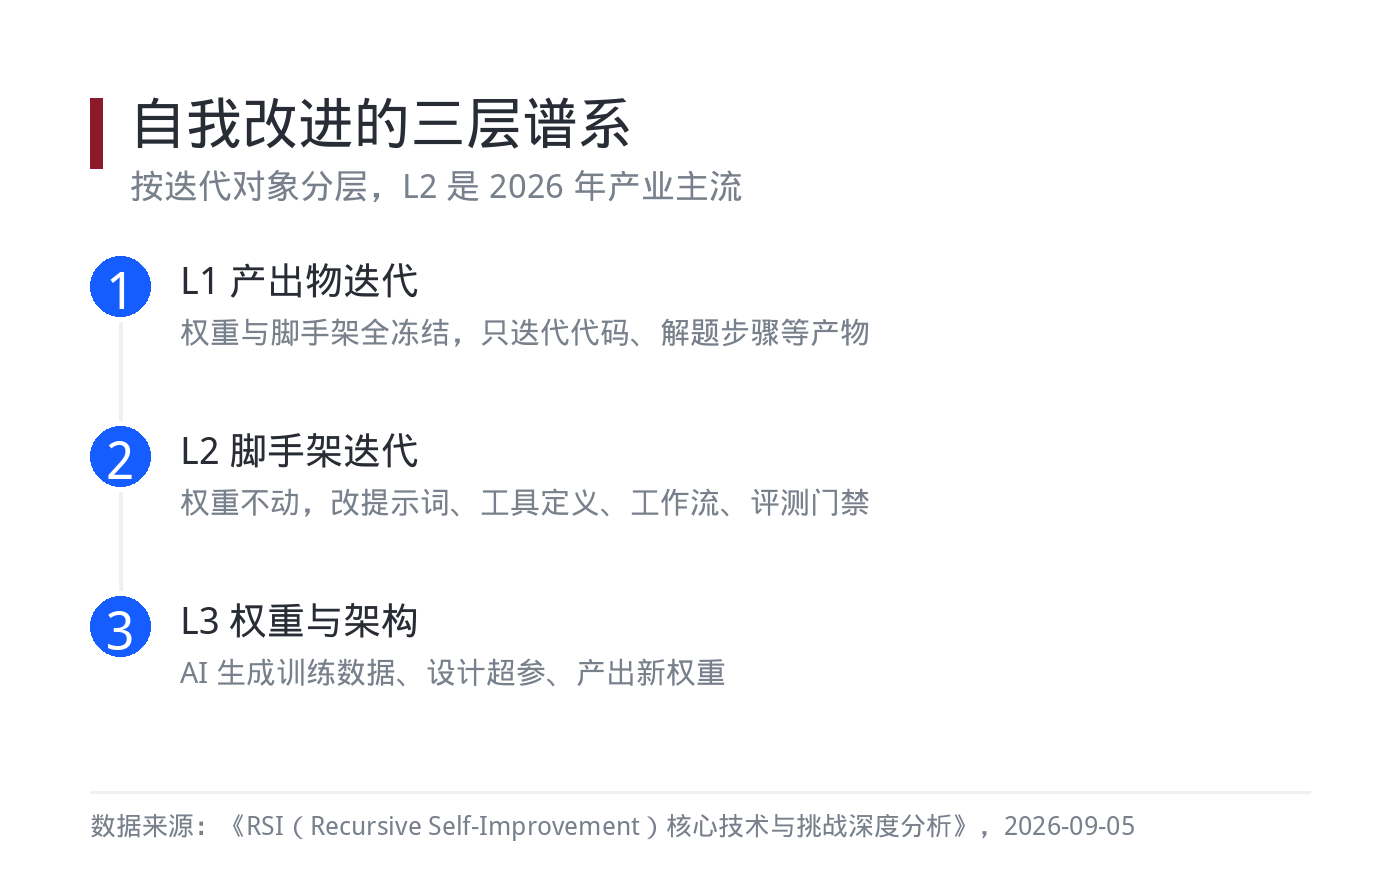
图注:L1 改产物、L2 改脚手架、L3 改权重;今天产业主流在 L2,被量出低分的是 L3(数据来源:《RSI(Recursive Self-Improvement)核心技术与挑战深度分析》,2026-09-05)
源势AI观点
第一,把"AI 提效"和"AI 研发"分开算账。前者是 L1,用代码量、工单量就能测;后者是 L3,要拿复现实验来测。混在一张报表里,会得出"AI 已经很能干"的结论,但招不到对应的人。
第二,看评测先看它隔离了什么。AI4AI-Bench 把代理指标和最终指标用墙隔开,这个设计比分数更值得抄。企业内部做 AI 效果验收,同样要把"干活时用的指标"和"上线后真正算分的指标"分开。
第三,把低分当路标,不当判决。这些数字说明的是 L3 今天的位置,不是终局。真正该记的是那把尺子——以后每次新模型出来,在同一把尺上比。
话题标签:#AI研发 #递归自我改进 #评测口径
