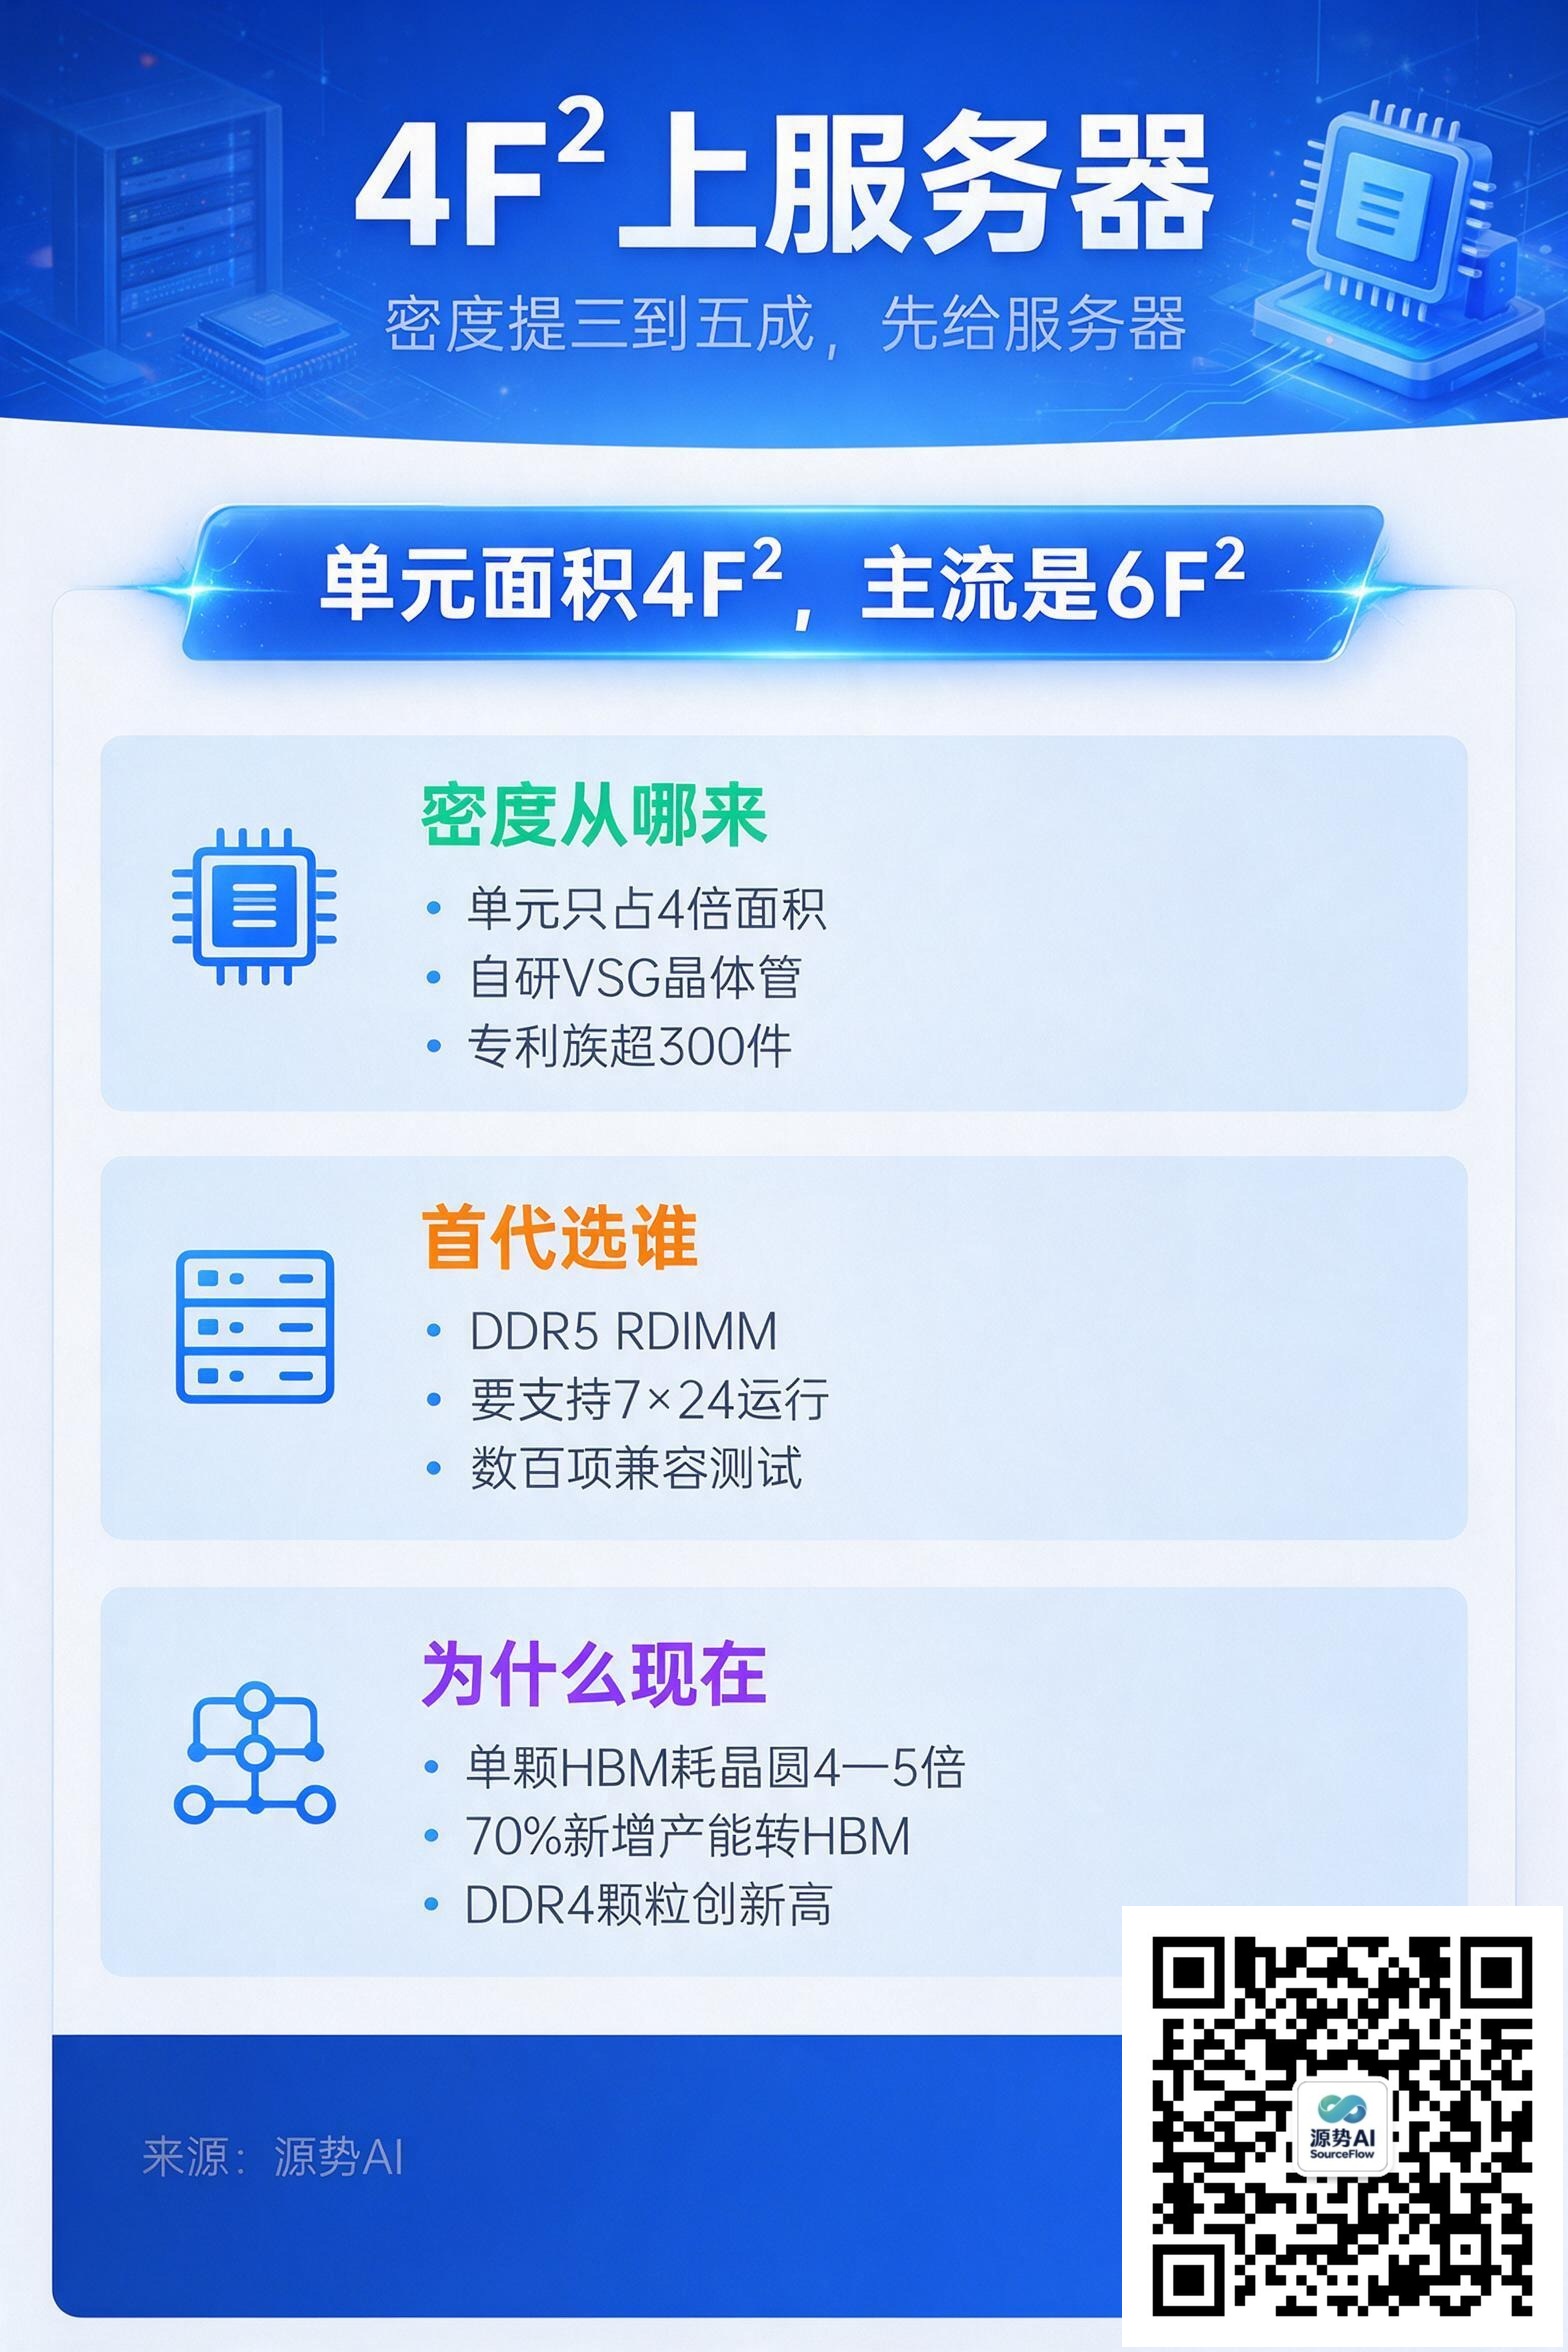
存储行业换架构,通常先在消费级试水。这一次,长鑫把首代 4F² 产品直接指向了服务器内存。
10 月 9 日至 10 日举行的第四届集成芯片和芯粒大会上,长鑫存储总裁曹堪宇宣布,预计今年年底推出融合 4F² 架构与混合键合等先进技术的新一代 DDR5 RDIMM 产品(来源:科创板日报、IT之家,2026-10-10,转引自 Tech Digest《AI行业24小时_20261012_10》)。
目前 DRAM 行业主流是 6F² 架构;4F² 意味着每个存储单元只占 4 倍最小特征尺寸的平方(来源:《AI行业24小时_20261012_10》,2026-10-10)。按架构推算,单位面积存储密度理论上可提升 30% 至 50%——这是架构值,不是量产实测(来源:科创板日报、IT之家,2026-10-10,转引自《AI行业24小时_20261012_10》)。
密度是怎么挤出来的
DRAM 的单元密度,长期靠工艺微缩推进。到了这一代,微缩空间越来越窄,架构本身成了变量。
4F² 的核心是长鑫自研的 VSG(垂直包围栅)晶体管:用垂直包围沟道的结构强化栅控,解决漏电与短沟道效应。曹堪宇称长鑫在 4F² 方向上公开的专利族超过 300 件,数量领先海内外厂商,并在 2021 年发布了中国大陆首篇 4F² 架构论文(来源:科创板日报、IT之家,2026-10-10)。从 2021 年的论文到 2026 年底的产品,中间隔了约五年,这条路线的时间成本不低。
DRAM 的每个存储单元由一个电容和一个晶体管组成,"6F²""4F²"描述的是单元在版图上占多少面积——数字越小,同样一片晶圆能切出的单元越多。所以密度提升不一定需要更先进的光刻,把单元结构本身改小一圈也能拿到。
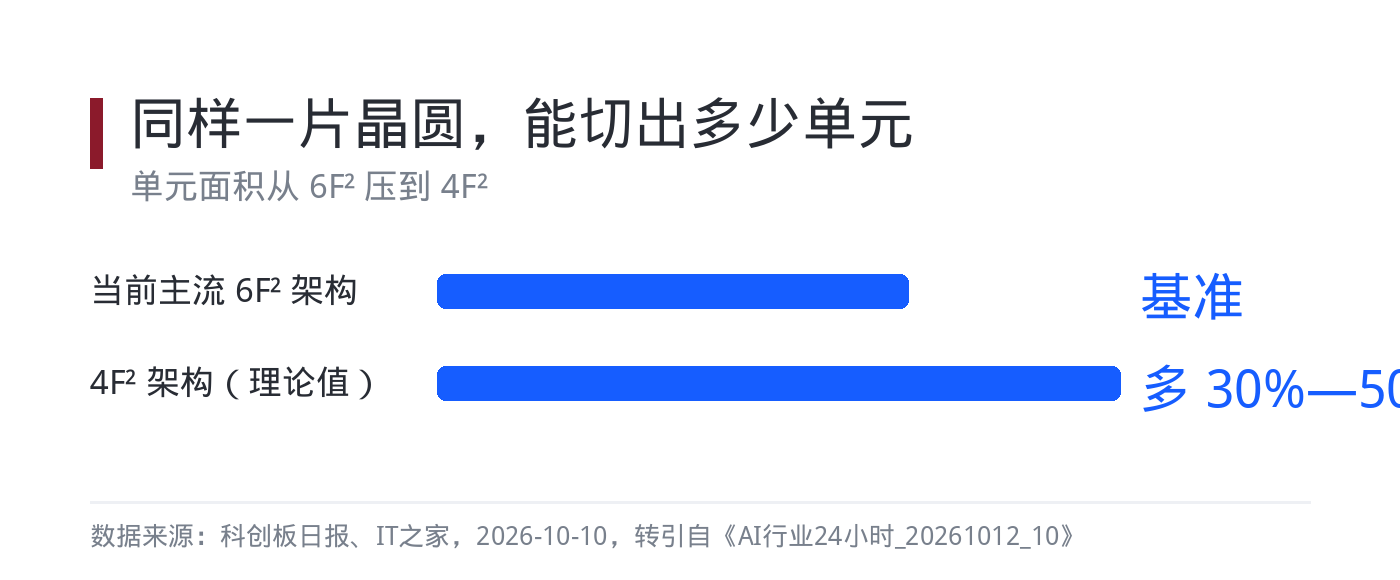
图注:单元面积从 6F² 压到 4F²,同样面积的晶圆理论上可多切出约三到五成单元(数据来源:《AI行业24小时_20261012_10》,2026-10-10)
需要说明的是,这个区间是架构理论值,不是量产实测数据。演讲也没有公布这款 DDR5 RDIMM 的规格信息与具体发布时间(来源:科创板日报、IT之家,2026-10-10)。
首代就上服务器
RDIMM 是带寄存器的内存条,主要面向服务器。它要支持 7×24 小时运行,还要通过与不同厂商、不同代际 CPU 和主板的数百项兼容性测试,落地难度高于消费级内存(来源:科创板日报、IT之家,2026-10-10)。
把首代产品放到这个位置,代价是验证周期长,收益是它对准了当下需求最紧的那块市场。公告没有说明为什么首代就选服务器;以下是我们基于供给结构的推断:通用 DRAM 的产能正被 HBM 挤占,服务器侧的缺口最先显形(来源:《AI行业24小时_20260906_10》,2026-09-06)。
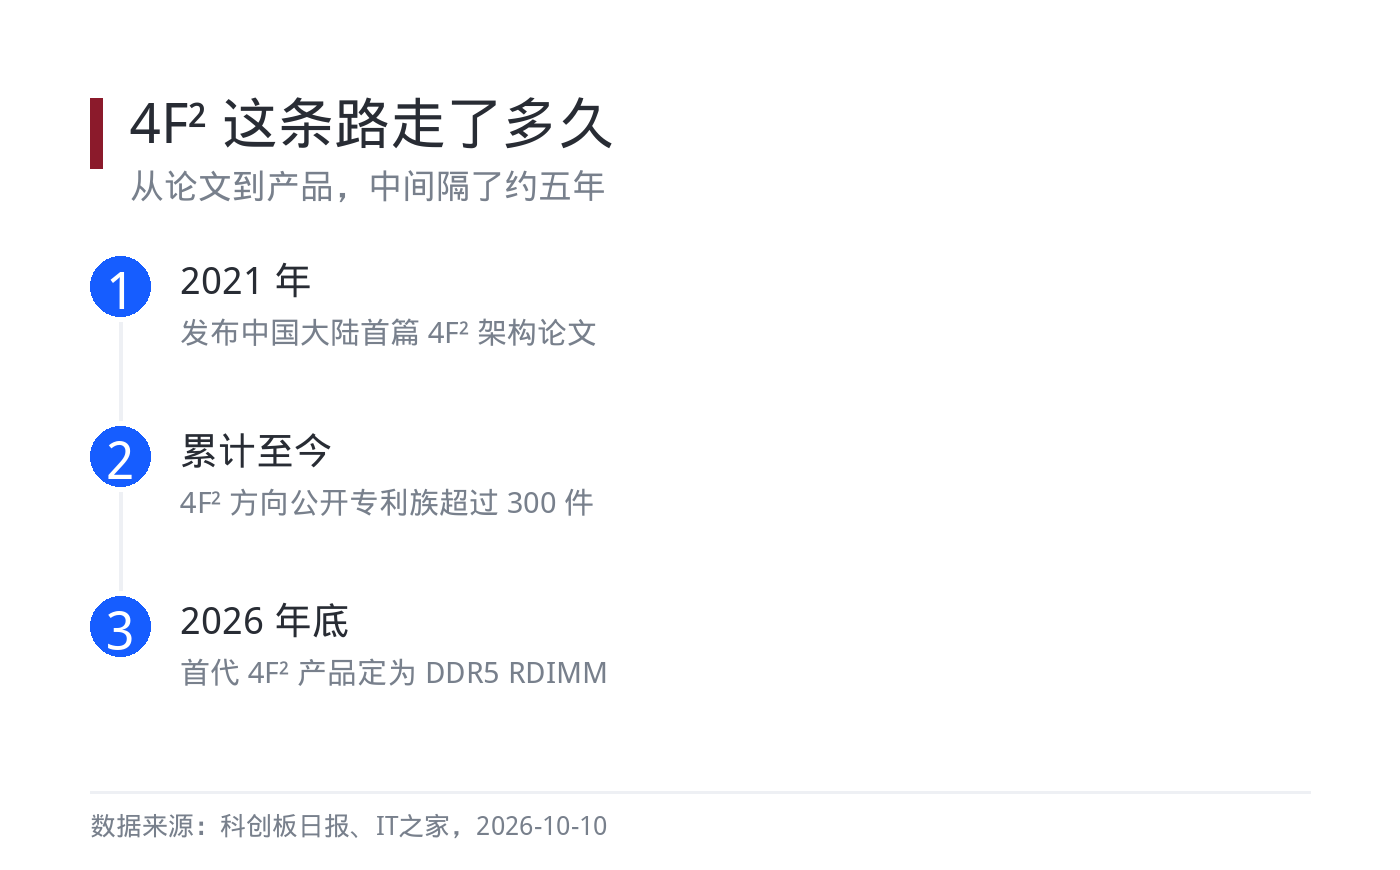
图注:4F² 从 2021 年的论文到 2026 年底的产品走了约五年,首代产品直接定为服务器用的 DDR5 RDIMM(数据来源:科创板日报、IT之家,2026-10-10)
内存为什么成了地板价
要看清这款产品的意义,得先看它在产业链里的位置。
AI 服务器和通用服务器的差别,不只在 GPU 数量。同样一台机器,AI 机型要配的存储容量远超普通设备——抢产能的从来不是 GPU,是内存。机制不复杂:单颗 HBM 消耗的晶圆远高于同容量的 DDR5,利润率也更高;三大原厂把 70% 新增产能转向 HBM 之后,通用 DRAM 的供给自然塌了一块(来源:《AI行业24小时_20260906_10》,2026-09-06;源势AI《算力地板,改由内存定价》,2026-09-06)。
价格已经在动。显存短缺把英伟达专业卡官方价推高 20.8% 至 1.6 万美元,DDR4 颗粒创历史新高,三星七成产能锁定 HBM 长约;同期还记录到,Q3 DRAM 合约价预计再涨 32%(来源:源势AI《算力地板,改由内存定价》,2026-09-06;Tech Digest《AI行业24小时_20260906_10》,2026-09-06)。
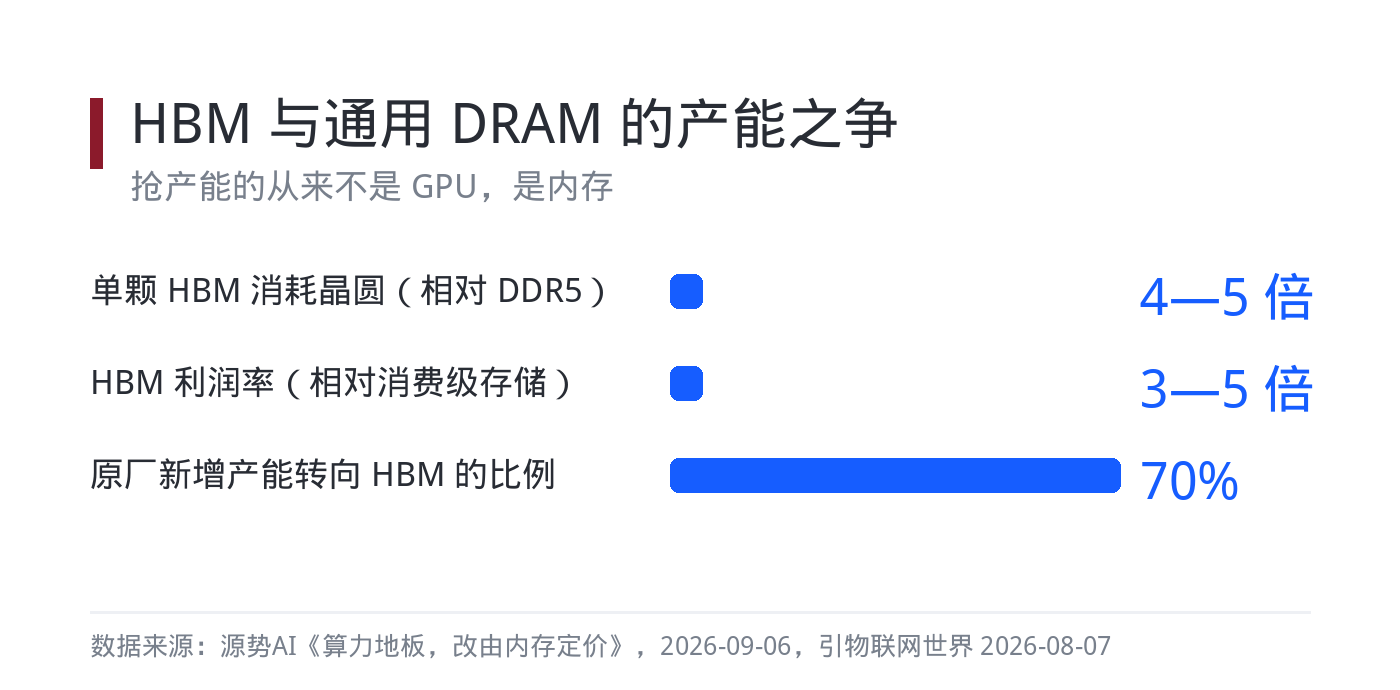
图注:三大原厂把 70% 新增产能转向 HBM,通用 DRAM 的供给被挤压(数据来源:《AI行业24小时_20260906_10》,2026-09-06)
在这个背景下,密度提升的含义就具体了:同样的晶圆产能,能产出更多通用内存。对采购方来说,这是把"内存成本"从被动接受价格,往产能端挪了一小步。
从采购角度看,这层变化最终会落在两个指标上:单条 RDIMM 的容量上限,以及同一机架里能塞进多少容量。前者决定单机能不能装下越来越大的模型权重与 KV 缓存,后者决定集群的占地与配电成本。密度提升的收益,会先出现在这两处,而不是直接体现在内存的标称价格上。
源势AI观点
第一,算力预算按季度重排,而不是按年锁。内存合约价的波动周期比 GPU 短,报价单如果还是年度锁价,两三个季度后就会失去参考价值。做推理成本测算的团队,建议把 DRAM 合约价单列成一行,跟 token 单价同比。
第二,看国产存储先看架构,不只看制程。制程微缩的边际收益在下降,架构换代的收益是可算的。4F² 这类路线能否量产,是比"第几代"更值得跟的指标。
第三,跟住良率与混合键合的成熟度。架构给出的是理论密度,能不能按年底的时间表落地,取决于 4F² 的良率与混合键合工艺。对采购方来说,这两项比发布节奏更值得盯。
第四,把内存写进容量规划的最前面。模型权重只要装不下,整卡就得闲置;KV 缓存一旦不够,并发数就得砍。这两件事都是内存容量问题,不是算力问题,规划顺序上应该排在 GPU 采购之前。
话题标签:#存储芯片 #4F²架构 #算力成本
